Corres la suite de pruebas contra el servicio que generó tu agente, sale todo en verde y lo mandas a producción. Lo hiciste cientos de veces con código escrito a mano y la regla nunca falló: si las pruebas pasan, el comportamiento que probaste es correcto. La diferencia es que ese código producía la misma salida cada vez que lo ejecutabas. El agente, no. Le das la misma entrada dos veces y te devuelve dos cosas distintas, las dos plausibles, una de ellas con un error que la prueba de hoy no tocó.
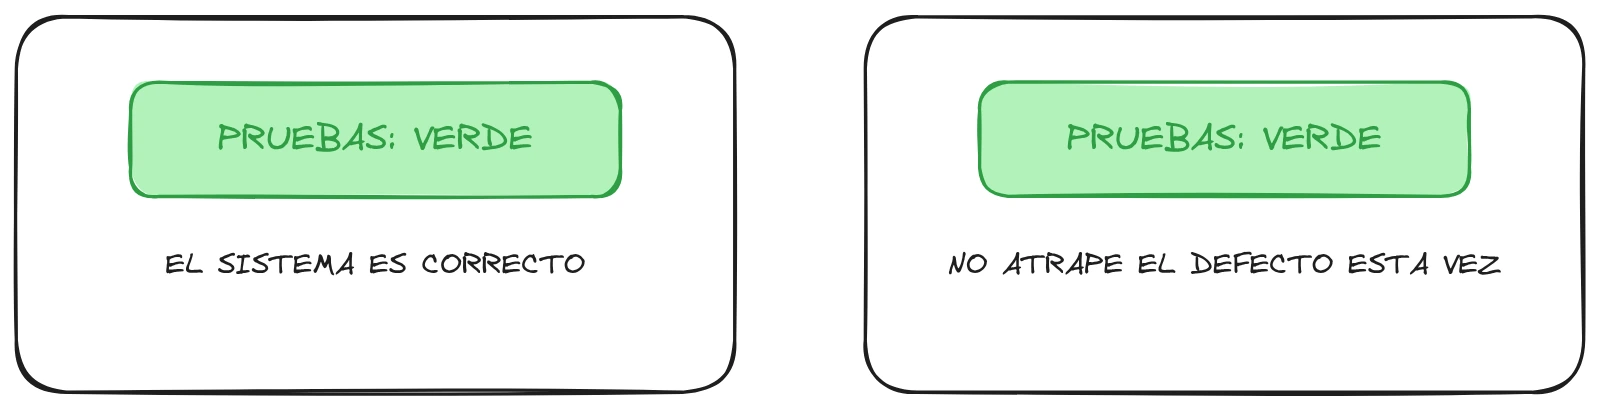
Y ahí la regla se rompe sin avisar. Con una salida no determinista, una prueba que pasa ya no demuestra que el sistema sea correcto. Demuestra algo mucho más modesto: que en esta ejecución no atrapaste un defecto. El verde dejó de ser una compuerta y se convirtió en una muestra.
¿Por qué una prueba sobre un sistema determinista sí demostraba?
Porque la ejecutabas una vez y esa vez valía por todas. Un if que devuelve true para una entrada la va a devolver siempre para esa entrada; no hay nada que muestrear, hay una sola realidad y la observaste entera. La prueba era una compuerta en el sentido literal: o pasas o no pasas, y si pasas, está demostrado para ese caso.
El no determinismo rompe justo ese supuesto. La salida del agente para una entrada fija no es un valor, es una distribución: la mayoría de las veces acierta, algunas se desvía. Observar una ejecución es sacar una bolita de una urna que no vacías. La próxima bolita puede ser de otro color, y la prueba de hoy no sabe nada de las bolitas que no sacó.
El verde es un muestreo de aceptación, no un certificado
La manufactura lleva un siglo con exactamente este problema y le puso nombre: muestreo de aceptación. Cuando revisar el cien por ciento de un lote es demasiado caro, destruye el producto o tarda demasiado, no inspeccionas todo: tomas una muestra, cuentas los defectos y decides si aceptas el lote entero. La estadística que lo sostiene (los planes de muestreo, el nivel de calidad aceptable, la curva característica) nació para los lotes de munición de la Segunda Guerra Mundial y sigue viva en las normas ISO.
Lo primero que te dice esa disciplina es incómodo: muestrear no demuestra que el lote esté limpio. Te da una probabilidad de aceptarlo dado un nivel de defectos, con su riesgo asociado. Aceptar un lote nunca significó «no hay defectos»; significó «la muestra no encontró suficientes para rechazarlo». Es exactamente el salto que hay entre «las pruebas pasaron» y «el sistema es correcto», y en el software lo veníamos ignorando porque el determinismo nos regalaba el cien por ciento de inspección gratis en cada corrida.
Vale la pena detenerse en por qué esta metáfora aguanta y no es solo una imagen bonita. Gregor Hohpe tiene una prueba para eso en Mighty Metaphor: una metáfora sirve para pensar, y no solo para decorar, cuando las dinámicas coinciden, no cuando las imágenes se parecen. Apliquémosla. En el muestreo de aceptación, inspeccionar al cien por ciento es inviable (destruye el producto, cuesta demasiado) y por eso muestreas; en un agente, inspeccionar al cien por ciento es imposible porque el espacio de entradas y de salidas es efectivamente infinito, así que también muestreas. En los dos casos el resultado no es un veredicto binario sobre el lote, es una probabilidad con un riesgo. Y en los dos casos la decisión real no es «¿paso o rechazo este lote?», sino «¿qué tasa de defectos estoy dispuesto a aceptar y qué tamaño de muestra respalda esa decisión?».
Las dinámicas coinciden, así que la metáfora deja pensar más allá de lo que escribí: si el verde es un muestreo, entonces una prueba que corre una sola vez tiene un tamaño de muestra de uno, el peor plan de muestreo que existe; entonces tiene sentido hablar de un nivel de calidad aceptable para la salida de tu agente, igual que una fábrica declara su AQL; y entonces «flaky» deja de ser un insulto a la prueba y pasa a ser información sobre la distribución que estás muestreando. Nada de eso lo argumenté y ya lo estás deduciendo. Eso es lo que separa un modelo de un adorno.
La cuenta de la servilleta: ¿cuánto demuestra un verde?
Pongámosle números, con los supuestos a la vista para que rehagas la cuenta con los tuyos. Esto no es la medición de un sistema real; es aritmética para pensar.
Supón que la salida del agente es defectuosa con probabilidad en cada ejecución, y que las ejecuciones son independientes y con la misma (dos supuestos fuertes; ya volvemos a ellos). Si corres la prueba una vez y pasa, lo único que sabes es que caíste en el 1 − p de las veces buenas. La probabilidad de que ejecuciones independientes atrapen al menos un fallo es:
Metamos un defecto del 5 %, o sea . Con una sola corrida () la probabilidad de atraparlo es exactamente ese 5 %. Dicho al revés, y aquí está lo que incomoda: un verde con una sola corrida te deja un 95 % de probabilidad de que simplemente no pisaste el camino malo. No es que el sistema sea correcto; es que no lo miraste bien.
¿Cuántas corridas hacen falta para estar razonablemente seguro, digamos un 95 %, de atrapar un defecto que aparece el 5 % de las veces? Despejamos:
O sea 59 corridas para cruzar la línea. Pasaste de una prueba a cincuenta y nueve, y lo único que compraste fue un 95 % de confianza frente a un defecto bastante gordo. Si el defecto fuera del 1 %, la misma cuenta pide unas 299 corridas. La intuición de que «pasó la prueba» equivale a «funciona» se desarma en cuanto le pones el exponente.
Un verde con una sola corrida no es la prueba de que el sistema sea correcto; es la prueba de que no lo atrapaste esta vez.
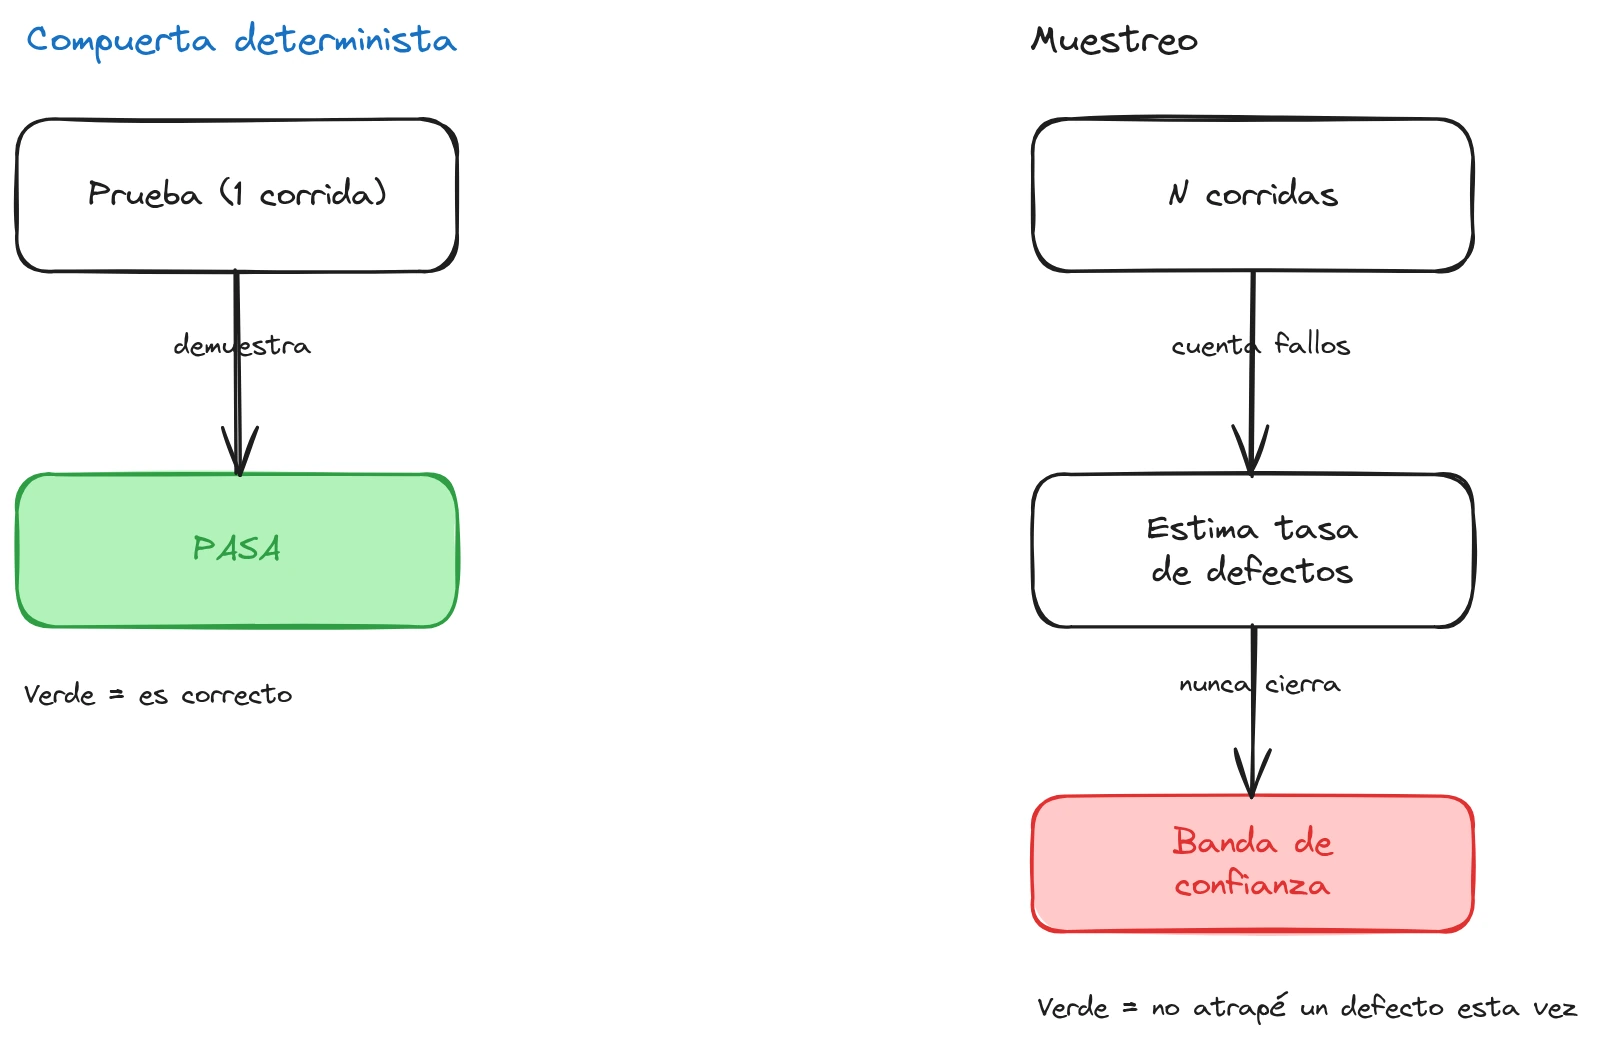
La compuerta determinista demuestra; el muestreo estima con un intervalo. No son el mismo gesto con más repeticiones: son dos cosas distintas.
Sé lo que estás a punto de decir
Entonces corro la suite mil veces en el pipeline y listo, muestreo grande y a dormir tranquilo.
Ojalá fuera tan fácil, y la propia estadística del muestreo te explica por qué no. La cuenta de arriba se apoya en dos supuestos que en un agente son frágiles. El primero es que las corridas son independientes: si fijas la semilla, bajas la temperatura o cacheas, mil corridas se parecen más a una corrida repetida mil veces, y tu tamaño de muestra efectivo vuelve a ser cercano a uno. El segundo es que es fija: no lo es. Cambias el prompt del sistema, el proveedor actualiza el modelo por debajo, entra una entrada de una región del espacio que nunca muestreaste, y la distribución que tanto trabajo te costó muestrear ya es otra. Acabas de recibir un lote nuevo de un proveedor que cambió su línea de producción sin avisarte, y tu plan de muestreo era para el lote viejo.
Multiplicar las corridas ayuda, pero tiene rendimientos decrecientes y un techo: por muchas que corras, nunca llegas a «demostrado», solo a «un intervalo de confianza más estrecho». Y cada corrida cuesta tokens y tiempo. En algún punto, seguir muestreando es más caro que atacar el problema por el otro lado.
¿Y cuál es el otro lado?
El muestreo de aceptación trae su propia lección, y es la que de verdad importa. La industria no se quedó inspeccionando lotes para siempre: Toyota se dio cuenta de que inspeccionar más barato no es lo mismo que tener menos defectos, y movió el esfuerzo de inspeccionar la salida a diseñar el proceso para que el defecto sea imposible. Es el poka-yoke de Shigeo Shingo: la pieza que solo encaja en la posición correcta, el conector que no entra al revés. No detectas el error después; haces que no pueda ocurrir.
Traducido a un agente: dejar de preguntar «¿la salida pasó la prueba?» y empezar a preguntar «¿qué restricción hace que esta clase de salida ni siquiera sea posible?». Si el agente nunca debió borrar un recurso de producción, el muestreo que lo atrape el 5 % de las veces es la respuesta equivocada; la respuesta es que no tenga el permiso para hacerlo. Ahí es donde una plataforma como Amazon Bedrock AgentCore deja de ser infraestructura y se vuelve el sitio donde vive el poka-yoke: identidad, permisos y guardrails que acotan lo que el agente puede tocar, de modo que la clase entera de defecto queda fuera del espacio de salidas y no hace falta muestrearla. Y donde el flujo dirigido por especificaciones de Kiro convierte la spec en el criterio de aceptación explícito contra el que se comprueba lo generado, en vez de dejar que «lo que haga pasar la prueba» sea la definición implícita de correcto.
Esto no sustituye al muestreo; lo reserva para lo que no se puede volver imposible. Lo que sí se puede acotar con una restricción, se acota, y sale del lote que hay que inspeccionar. Es la misma mudanza de palanca que argumenté en El código es inventario, no un activo: cuando producir sale barato, el control del arquitecto se traslada de revisar cada pieza a diseñar las restricciones que la fábrica lee antes de producirla.
Mi sugerencia
El lunes, antes de volver a tratar un verde como un certificado, decide dos números y escríbelos en el ADR del servicio: qué tasa de defectos estás dispuesto a aceptar en la salida del agente, y cuántas corridas respaldan ese «verde». Si el número de corridas es uno, ya sabes que tu plan de muestreo es el peor que existe y que estás llamando «demostrado» a un tamaño de muestra de uno.
Y para la mitad que no quieras muestrear, haz la pregunta del poka-yoke sobre cada clase de defecto que te asuste: ¿esto lo atrapo con más corridas, o lo vuelvo imposible con una restricción? Mueve a guardrails y a specs todo lo que admita volverse imposible, y reserva el muestreo para lo que de verdad es una distribución que hay que estimar. Si al final del ejercicio tu suite sigue corriendo una sola vez y no hay una sola restricción que haga imposible el peor defecto, no tienes una compuerta de calidad: tienes una bolita de una urna que no vaciaste, y la estás llamando demostración. ;)